Crawl budget e WordPress: quanto Google spende per scansionare il tuo sito
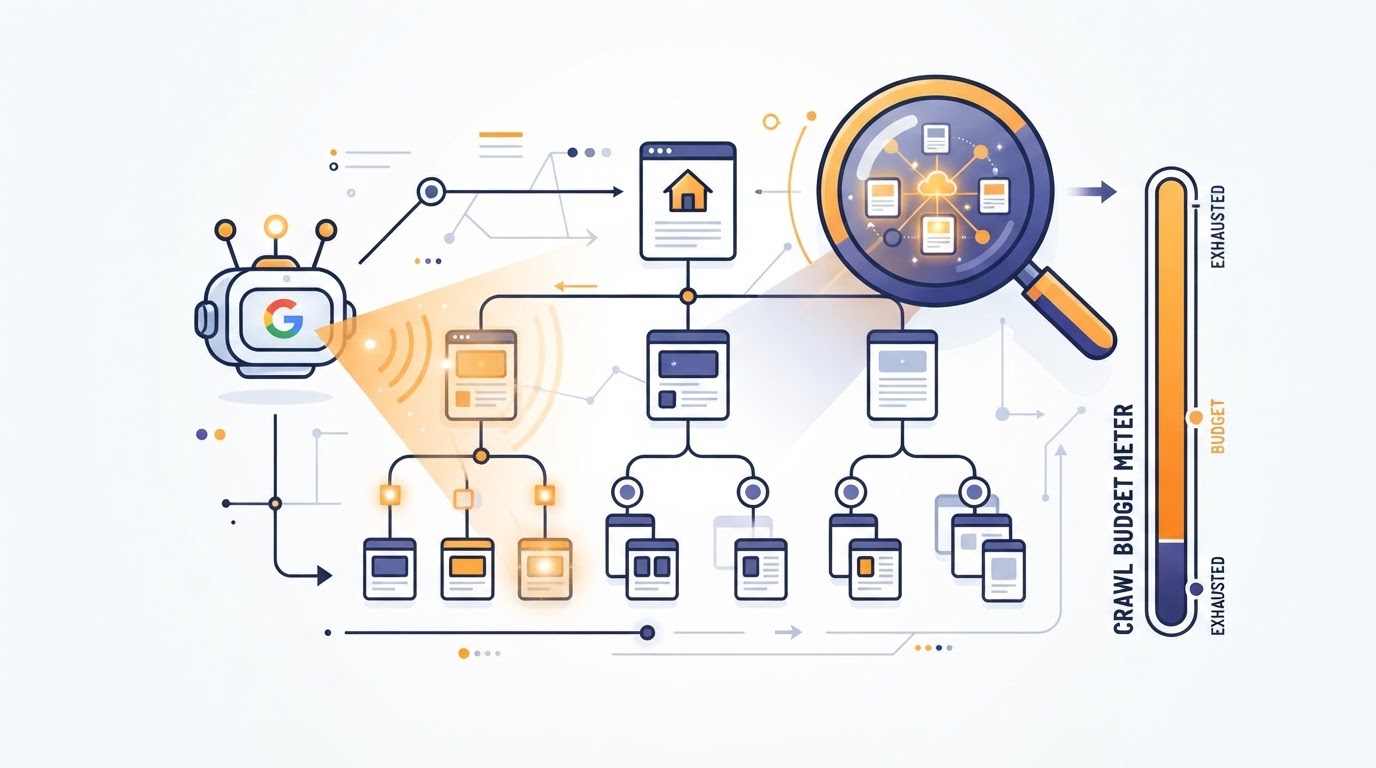
Il crawl budget è quanto Google spende in tempo e richieste per scansionare il tuo sito. Su siti piccoli non è un problema; su siti grandi con migliaia di URL, ogni URL sprecato è un URL utile che Google non indicizza. Come ottimizzare il crawl budget con robots.txt, sitemap e canonical, senza cadere nella trappola di over-ottimizzare siti che non ne hanno bisogno.
Il crawl budget è uno di quei concetti SEO che viene spiegato male la metà delle volte. La definizione semplice: è la quantità di risorse — tempo e richieste — che Google dedica a scansionare il tuo sito in un dato periodo. Se il tuo sito ha 100 URL e Google ne scansiona 50 al giorno, il crawl budget è 50; gli altri 50 aspettano. Su un sito con 100 URL, non è un problema: Google torna e li scansiona tutti. Su un sito con 50.000 URL, ogni URL che Google scansiona inutilmente è un URL utile che aspetta.
La prima cosa da capire è quando il crawl budget conta davvero. Google stesso lo dice: per la maggior parte dei siti — quelli sotto qualche migliaio di URL — il crawl budget non è un fattore limitante. Google ha risorse sufficienti per scansionarli tutti. Diventa un problema su siti molto grandi, su siti con tante URL generate automaticamente (filtri, paginazione, faceted search) e su siti con contenuti duplicati che sprecano scansione.
Cosa spreca il crawl budget
I principali sprechi sono tre. Primo: URL duplicate o con parametri che generano varianti della stessa pagina (ordinamento, filtri, paginazione infinita). Ogni variante è una URL che Google scansiona, e se sono tutte simili, Google le considera duplicati e ne sceglie una — ma ha speso scansione su tutte. Secondo: URL che restituiscono 404 o redirect a catena. Google scansiona, scopre che non c'è nulla, e ha speso una richiesta per niente. Terzo: pagine di bassa qualità che non meritano indicizzazione, ma che Google scansiona perché non gli dici il contrario.
L'ottimizzazione parte dalla sitemap XML: è la mappa che dai a Google delle URL che contano. Una sitemap pulita, con solo le URL canonical, aggiornata automaticamente, è il primo segnale. Le URL che non vuoi indicizzare vanno escluse con robots.txt o con meta robots noindex — ma robots.txt blocca la scansione, non l'indicizzazione, e una URL bloccata con robots.txt ma linkata può comunque finire in indice senza contenuto.
# robots.txt — ottimizzazione crawl budget

# Blocca le URL di bassa qualità (non scansionare = non sprecare)
Disallow: /*/feed/$
Disallow: /*/feed/rss/$
Disallow: /?attachment_id=
Disallow: /?p=

# Blocca i parametri di tracciamento che generano duplicati
Disallow: /*?utm_source=
Disallow: /*?utm_medium=
Disallow: /*?gclid=

# Blocca le varianti di ricerca interna (se non le vuoi indicizzare)
Disallow: /?s=
Disallow: /search/

# NON bloccare i file CSS/JS: Google li usa per renderizzare
# Allow: /*.css$
# Allow: /*.js$Canonical: la risposta al duplicato
Il tag canonical è il segnale più forte contro il contenuto duplicato. Dice a Google 'questa è la URL canonica, le altre varianti sono copie'. Su WordPress, il canonical è gestito dal core e dai plugin SEO per i post e le pagine. Il problema nasce con le URL generate da parametri — filtri, ordinamenti, paginazione — dove ogni variante può avere lo stesso contenuto della canonica. In quei casi, il canonical deve puntare alla versione principale, non a se stesso.
La trappola da evitare è over-ottimizzare. Su un sito con 200 URL, passare giorni a perfezionare robots.txt e canonical per il crawl budget è tempo perso: Google li scansiona tutti comunque. Il crawl budget è un'ottimizzazione per siti grandi, dove il volume rende ogni spreco misurabile. La domanda giusta è: Google Search Console → Scansione → Statistiche di scansione. Se Google scansiona poche pagine al giorno rispetto al totale, c'è margine. Se scansiona tutto, il crawl budget non è il tuo problema.
Il crawl budget è una delle tante leve SEO, e come tutte le leve va usata dove conta. Su un sito editoriali con migliaia di articoli, ottimizzarlo significa che gli articoli nuovi vengono indicizzati prima. Su un sito vetrina, è tempo meglio speso altrove — sui contenuti, sulle prestazioni, sui link. Un audit SEO tecnico include la verifica del crawl budget solo quando il volume lo giustifica, e ti dice esattamente dove intervenire e dove è inutile.
Misura LCP, INP e CLS sui tuoi utenti reali, non su un test di laboratorio.
Un audit Core Web Vitals identifica esattamente cosa rallenta il tuo sito e dove intervenire con priorità, incluso il crawl budget quando il volume lo giustifica.
Articoli correlati
JavaScript di terze parti e INP: il nemico silenzioso delle interazioni WordPress
Leggi
SEO mobile-first: come Google indicizza oggi (e cosa cambia per WordPress)
Leggi